Un conjunto de pruebas en el que nadie confía es un conjunto de pruebas que nadie usa. Cuando las pruebas automatizadas de API fallan, rara vez es culpa de la herramienta. Lo que ocurre es que las pruebas se rompen sin motivo aparente, alguien las saca del pipeline y el equipo vuelve directamente a comprobar las cosas a mano.
El éxito depende mucho más de su estrategia que de sus herramientas de prueba. Los obstáculos reales son encontrar el punto de partida adecuado, priorizar las siguientes pruebas y garantizar la fiabilidad a largo plazo.
Las pruebas automatizadas de API consisten en ejecutar comprobaciones programadas contra los endpoints, los contratos y las respuestas de su API en cada cambio de código en lugar de hacerlo a mano. Bien hechas, empiezan con un conjunto reducido de endpoints de alto tráfico y alto riesgo, se amplían por tipo de prueba en un orden deliberado y se ejecutan dentro de CI/CD para que un fallo aflore a los pocos minutos del commit que lo provocó.
Esta guía cubre qué automatizar primero, cómo secuenciar la cobertura y cómo mantener vivo el conjunto una vez que existe. Nada de ello depende de un framework concreto, y es el mismo enfoque que aplicamos en los proyectos de pruebas de API de nuestros clientes.
Lo que cuesta empezar, y lo que cuesta equivocarse
Planifique la primera fase en semanas, no en trimestres. Un primer conjunto que cubra los diez a quince endpoints que soportan más tráfico y más riesgo es trabajo realista para un ingeniero que conozca el stack, integración en el pipeline incluida, en dos a cuatro semanas.
Los presupuestos rara vez se rompen en esa primera fase. Se rompen en el segundo año. Un conjunto que creció sin estructura llega al punto en que nadie sabe qué fallos son reales, y la única salida es reescribirlo. Eso se paga con tiempo de ingeniería ya comprometido para otra cosa.
Dónde compensan primero las pruebas automatizadas de API
Ordene sus endpoints por prioridad antes de escribir una sola prueba. Dos cosas deciden el orden: cuánto tráfico soporta un endpoint y cuánto daño causa cuando se rompe. La autenticación, los pagos y todo lo que escribe en un registro de cliente están en lo más alto de ambas listas. Un endpoint interno de administración que se usa dos veces al mes está al final, por fácil de probar que sea.
Luego automatice en este orden:
- Caminos felices en los endpoints principales. La petición que todo el mundo hace de verdad, con entrada válida y salida esperada. Es cobertura básica, y detecta la mayor parte de lo que rompe un despliegue.
- Comprobaciones de contrato y de esquema. Códigos de estado, campos obligatorios, tipos y forma de la respuesta validados contra su especificación OpenAPI o equivalente. Son baratas de generar a partir de la especificación y detectan los cambios que rompen cosas en silencio. Si un campo que antes devolvía un número empieza a devolver texto, la API sigue respondiendo con un código de éxito. Nada parece ir mal hasta que una app que depende de ese campo se cae.
- Casos negativos y límite en esos mismos endpoints. Falta de autenticación, cargas malformadas, tokens caducados, valores límite, nulos inesperados. Añádalos cuando los caminos felices estén en verde y estables, no antes.
- Todo lo demás, más tarde o nunca. La amplitud no es el objetivo. Un conjunto que cubre doce endpoints como es debido vale más que uno que cubre noventa de forma superficial.
El error que merece la pena nombrar aquí es intentar automatizarlo todo en el primer sprint. Los equipos que lo hacen acaban con una cobertura amplia y superficial que falla constantemente por motivos ajenos al código bajo prueba, y pierden el argumento a favor de la automatización antes de que haya tenido ocasión de devolver nada.
Cómo secuenciar las pruebas unitarias, de integración, de carga y de seguridad
No todos los tipos de prueba pertenecen al conjunto el primer día. Algunos necesitan un entorno maduro para decir algo cierto, y ejecutarlos pronto produce ruido que enseña al equipo a ignorar las builds en rojo. Secuenciarlos de forma deliberada es la única práctica que separa los conjuntos que sobreviven de los que acaban borrados.
Pruebas de API a nivel unitario
Durante el desarrollo, en el sprint en que se construye el endpoint
Lógica rota, códigos de estado incorrectos, deriva de esquema
Bajo
Pruebas de contrato
En cuanto un segundo consumidor depende de la API
Cambios que rompen a los clientes
Bajo
Pruebas de integración y de flujo
Cuando staging lleva dependencias reales y estados de datos reales
Encadenado de autenticación, errores de secuencia, estado que solo aparece entre llamadas
Medio
Paquete de regresión
Cuando ya tiene una cadencia de publicación repetible
Errores ya corregidos que vuelven
Medio
Pruebas de carga y rendimiento
Cuando el entorno se parece de verdad a producción
Techos de rendimiento, timeouts, agotamiento del pool de conexiones
Alto
Pruebas de seguridad
De forma continua desde el principio, profundizadas antes de cada versión
Huecos de autorización, inyección, exposición de datos
Medio
Hacer pruebas de carga demasiado pronto es sobre todo teatro. Ejecútelas contra una máquina de staging con una décima parte de los datos de producción y una configuración distinta del pool de conexiones, y el número que obtiene no habla de su API. Espere a que el entorno se parezca a producción en volumen de datos y topología, y trate entonces el resultado como una señal real. Llegado ese punto, las pruebas de rendimiento son un trabajo en sí mismas, no una comprobación más dentro del conjunto funcional.
Así funcionó, a grandes rasgos, el proyecto Couple Up!. El estudio detrás del juego narrativo para móvil esperaba un salto en el número de jugadores y quería saber por dónde cedería el backend, así que sometimos a prueba de carga un endpoint GET y tres POST en Apache JMeter, subiendo el volumen de peticiones paso a paso y observando los tiempos de respuesta. Lo instructivo no fue la herramienta. Antes de poder describir las peticiones correctamente, el cliente tuvo que rellenar huecos en su propia documentación de la API. Esa es una posición de partida normal, no un motivo para posponer las pruebas.
Las pruebas de seguridad son la excepción a la secuenciación. No esperan a un entorno maduro, porque la lógica de autorización o es correcta desde el primer commit o no lo es. Ejecute una línea base de forma continua y profundícela antes de cada versión. El OWASP API Security Top 10 es un punto de partida razonable sobre qué debería cubrir esa línea base, y las pruebas de seguridad retoman donde terminan las comprobaciones automatizadas.
El paquete de regresión es donde la mayoría de los conjuntos crecen sin control en silencio, así que decida de antemano qué se gana un sitio permanente en él. Nuestra guía sobre pruebas de regresión automatizadas cubre qué automatizar y qué dejar en paz.
Cómo mantener mantenible un conjunto de pruebas de API
La mantenibilidad no es una fase posterior a escribir las pruebas. Es un conjunto de decisiones que se toman mientras se escriben, baratas al principio y caras de aplicar después.
- Construya la lógica de las peticiones una vez y reutilícela. Constructores de peticiones compartidos, un único lugar donde vivan la URL base y la autenticación, nada de bloques de carga copiados y pegados. Cuando cambie la cabecera de autenticación, y va a cambiar, querrá una sola edición y no noventa.
- Sea dueño de sus datos de prueba. Las pruebas que dependen de un registro que alguien sembró en una base de datos de staging compartida hace seis meses fallarán un martes sin motivo que nadie pueda reconstruir. Cree lo que la prueba necesita y luego límpielo.
- Versione los casos de prueba junto al código de la API. Mismo repositorio, mismo pull request, misma revisión. Un cambio de contrato y la prueba que lo cubre deberían ser imposibles de fusionar por separado.
- Compare la especificación en cada merge. La mayoría de las roturas silenciosas se anuncian en el fichero de especificación antes de llegar a un consumidor. Compararlo con la versión anterior en CI convierte la deriva de esquema no detectada en una build fallida.
- Nombre las pruebas por el comportamiento, no por el endpoint.
rejects_expired_tokenle dice al siguiente ingeniero si un fallo importa.test_auth_3no.
La elección del framework importa aquí más que en ningún otro sitio, porque decide cuánta estructura obtiene gratis. Si todavía no ha elegido uno, nuestra guía de compra de herramientas de pruebas de API compara las principales opciones, y nuestra comparación de Karate y REST-Assured profundiza en dos de ellas, respaldada por trabajo real de automatización en Java y no por tablas de características.
Merece la pena conocer una opción más reciente: las herramientas que generan pruebas a partir del tráfico real de producción. Son genuinamente útiles para encontrar huecos de cobertura que no sabía que tenía, sobre todo en endpoints sin documentar. No sustituyen al diseño de pruebas revisado, porque una prueba generada a partir del tráfico copia lo que el sistema ya hacía, incluidas las partes que estaban mal. Úselas para encontrar los huecos y escriba luego la prueba usted mismo. La misma disciplina se aplica a las pruebas funcionales automatizadas en general.
Cómo integrar las pruebas de API en CI/CD
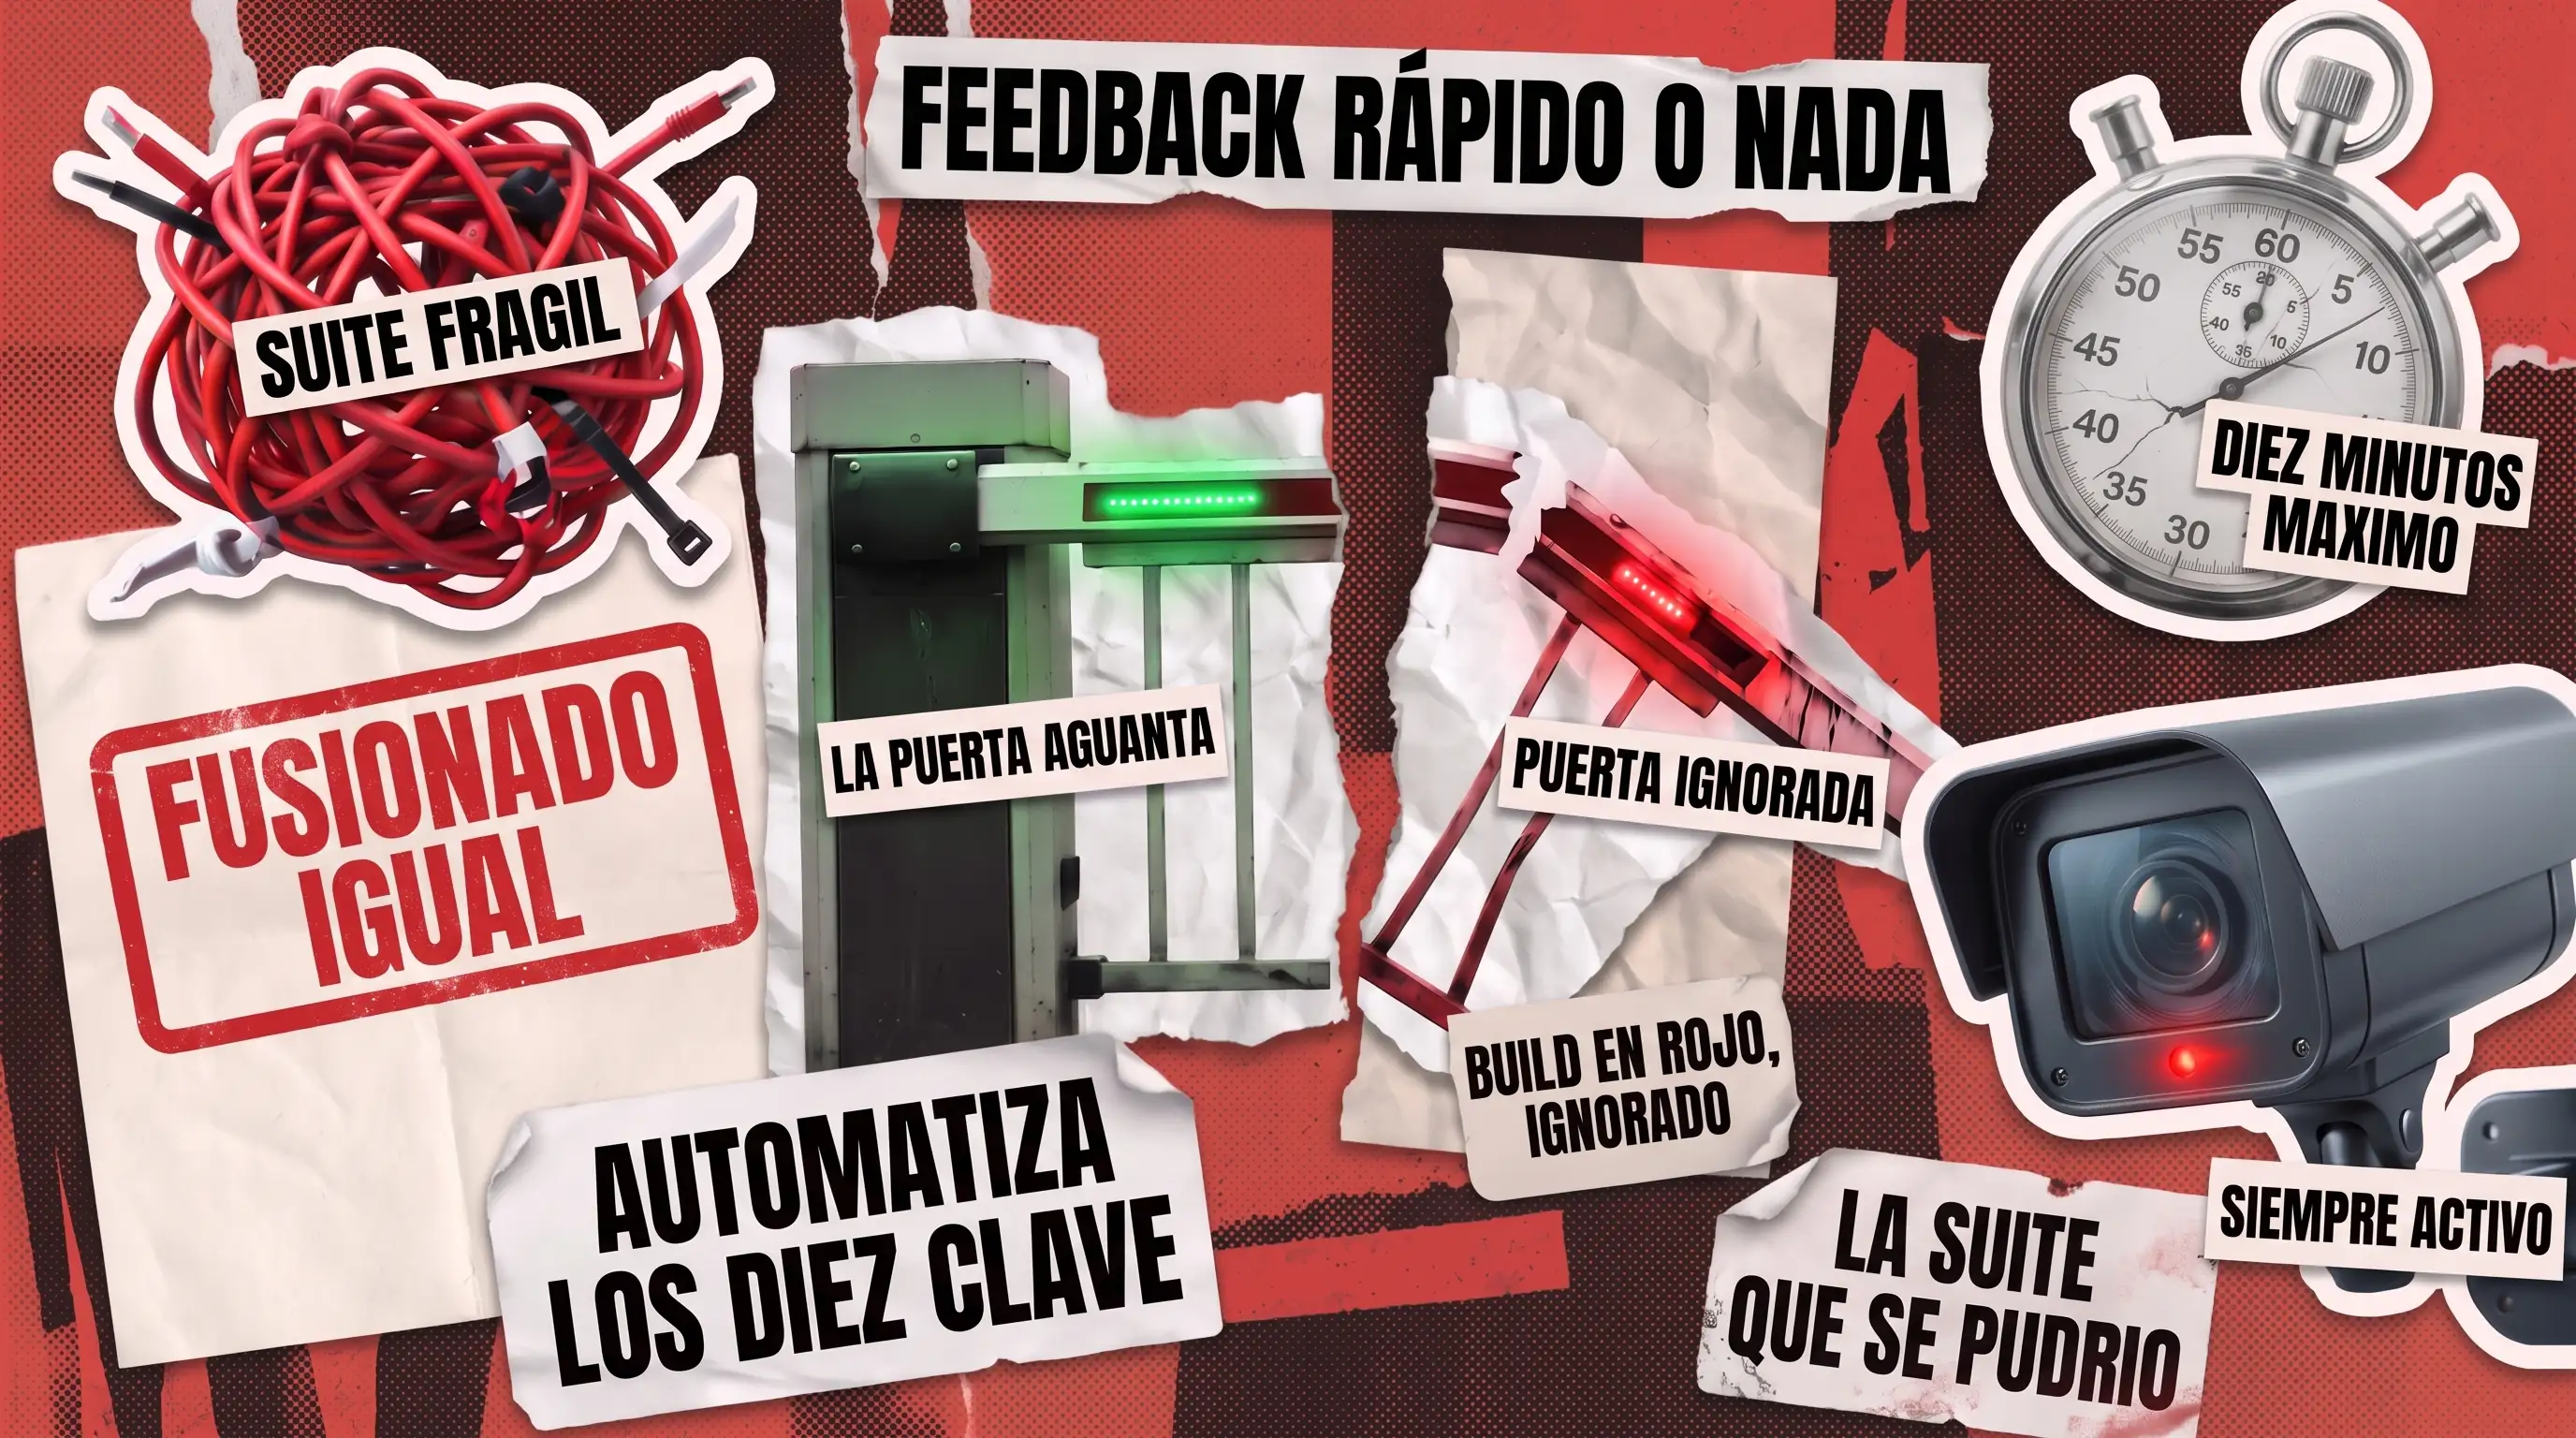
Las pruebas de API en CI/CD se ganan su sitio por la velocidad de la retroalimentación. Un fallo que un desarrollador ve cuatro minutos después de subir el código se arregla de inmediato. El mismo fallo aparecido en un informe nocturno se tría la semana siguiente, y para entonces hay tres commits más encima.
Divida el conjunto por etapa:
- En cada pull request: el subconjunto rápido. Comprobaciones de contrato y caminos felices en los endpoints críticos, menos de diez minutos en total. Esta puerta bloquea el merge.
- Al fusionar en main: el conjunto funcional y de regresión completo. Aquí es aceptable que sea más lento porque nadie está esperándolo para seguir trabajando.
- Cada noche o según un calendario: pruebas de carga y todo lo de larga duración.
- De forma continua: la línea base de seguridad.
Tres reglas lo mantienen honesto. Los fallos tienen que bloquear algo, o el conjunto es documentación y no una puerta. Las pruebas inestables se ponen en cuarentena y se arreglan dentro de un plazo definido, en lugar de reintentarse tres veces en la configuración del pipeline, que es como la credibilidad de un conjunto se desangra en silencio, un reintento cada vez. Y los resultados van a donde ya están los desarrolladores, en el propio pull request, no a un panel que alguien tiene que acordarse de abrir.
La cadencia de publicación es lo que vuelve esto urgente. En Granola, un bloc de notas con IA que lanza funciones nuevas más o menos una vez por semana, construimos un framework de automatización desde cero con Playwright, Electron y GitHub Actions, y automatizamos el 76% del conjunto de regresión principal en macOS y Windows. El equipo no tenía función interna de QA antes de eso, que es el caso habitual y no la excepción. Las publicaciones semanales no dejan margen para una pasada manual, así que el pipeline tiene que cargar con la regresión.
Cuándo la automatización es la decisión equivocada
La automatización encaja mal mientras una API sigue cambiando de forma cada semana. Antes del encaje producto-mercado, cuando los endpoints se renombran y las cargas se reestructuran entre sprints, las pruebas cuestan más de reescribir de lo que cuesta detectar los errores, y las pruebas manuales exploratorias contra la especificación son mejor inversión hasta que el contrato se asiente.
También es la decisión equivocada cuando nadie se hace cargo. Un conjunto automatizado es un producto con usuarios, y sin un responsable con nombre degenera en ruido en dos trimestres. Si no puede nombrar a la persona responsable cuando la build se pone en rojo, arregle eso antes de escribir ninguna prueba.
Cómo aborda Qawerk la automatización de pruebas de API
La mayoría de los equipos no llegan a nosotros con una hoja en blanco. Llegan con una API ya en producción, una cobertura parcial que alguien escribió hace dos años y un pipeline que ha aprendido a ignorarla. Qawerk se incorpora en el estado real en que esté el proyecto en lugar de exigir una build terminada, lo que en automatización de API suele significar auditar lo que existe, decidir qué merece conservarse y reconstruir el resto con una estructura que el equipo pueda mantener cuando nos vayamos.
Ese trabajo es práctico. Construimos los conjuntos nosotros mismos en lugar de entregar un documento de estrategia, en Java con Karate y REST-Assured entre otros stacks, y nuestros proyectos de pruebas automatizadas cubren cobertura funcional, de integración, de rendimiento y de seguridad en productos que van desde juegos independientes hasta herramientas de IA usadas en reuniones diarias. Los ingenieros de QA de Qawerk suman una media de nueve años de experiencia cada uno, lo que más importa en las decisiones de mantenibilidad de arriba, las que permanecen invisibles durante seis meses y luego deciden si el conjunto sobrevive.
Si prefiere empezar con un equipo que ya ha atravesado estas decisiones en otras API, hable con nosotros sobre automatizar sus pruebas de API.
Preguntas frecuentes
¿Qué debería automatizar primero en las pruebas de API?
Empiece por pruebas de camino feliz en los endpoints que soportan más tráfico y causan más daño cuando se rompen, normalmente autenticación, pagos y cualquier escritura en datos de clientes. Añada después validación de contrato y de esquema, y luego casos negativos y límite en esos mismos endpoints una vez que los caminos felices sean estables.
¿Cuánto se tarda en montar pruebas automatizadas de API?
Un primer conjunto que cubra diez a quince endpoints críticos, integrado en CI/CD, son de forma realista dos a cuatro semanas de trabajo para un ingeniero familiarizado con el stack. La cobertura completa de una API madura lleva más tiempo y debería añadirse de forma incremental en lugar de como un único proyecto.
¿Deberían ejecutarse las pruebas automatizadas de API en cada commit?
Un subconjunto rápido sí debería, idealmente por debajo de diez minutos, cubriendo comprobaciones de contrato y caminos felices en los endpoints críticos. El conjunto de regresión completo corresponde al merge en main, y las pruebas de carga corresponden a un calendario nocturno donde su duración no bloquea a nadie.
¿Puede la IA generar pruebas de API automáticamente?
Las herramientas que generan pruebas a partir del tráfico real de producción son útiles para encontrar huecos de cobertura, sobre todo en endpoints sin documentar. No sustituyen al diseño de pruebas revisado, porque una prueba generada copia lo que el sistema ya hacía, incluidos los errores existentes. Trate el resultado como una lista de huecos que abordar, no como un conjunto terminado.
¿Cuál es la diferencia entre pruebas automatizadas de API y pruebas de rendimiento de API?
Las pruebas automatizadas de API verifican que los endpoints se comportan correctamente: códigos de estado correctos, forma de respuesta correcta, gestión correcta de entradas erróneas. Las pruebas de rendimiento verifican que siguen comportándose correctamente bajo carga. Ambas deberían automatizarse, pero responden a preguntas distintas y corresponden a etapas distintas del pipeline.
Mira cómo preparamos para el futuro la primera API de emisión de tarjetas de África mediante automatización de pruebas, logrando 15 millones de dólares en financiación semilla.